“百模大战”才刚开始蚂蚁灵波却想拉着生态一起上桌
蚂蚁灵波为什么不急着赚钱?
作者:Colin
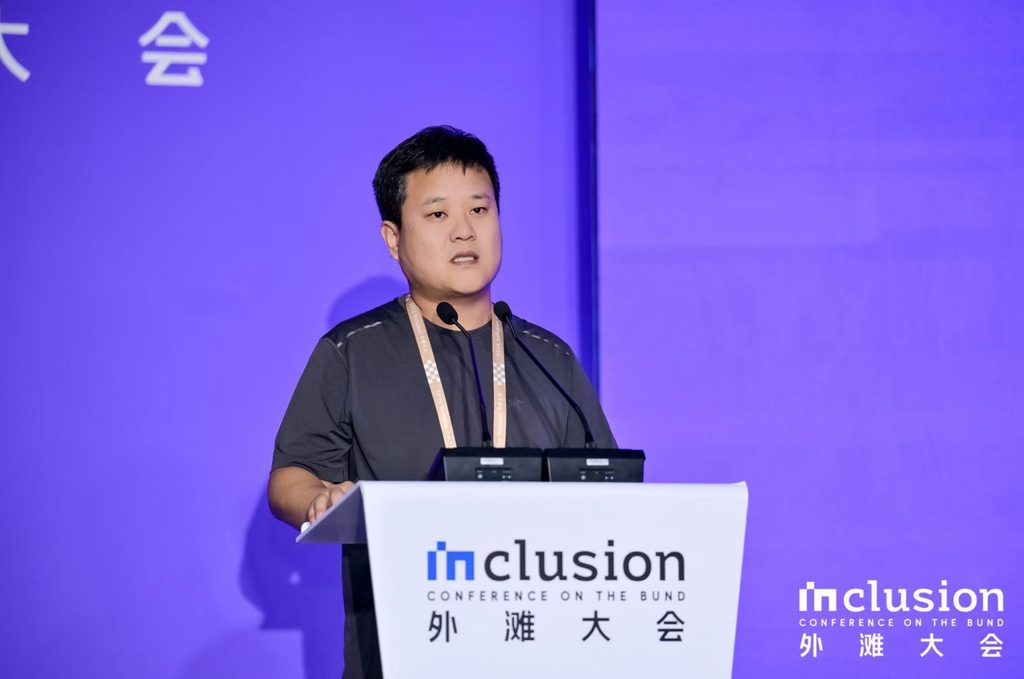
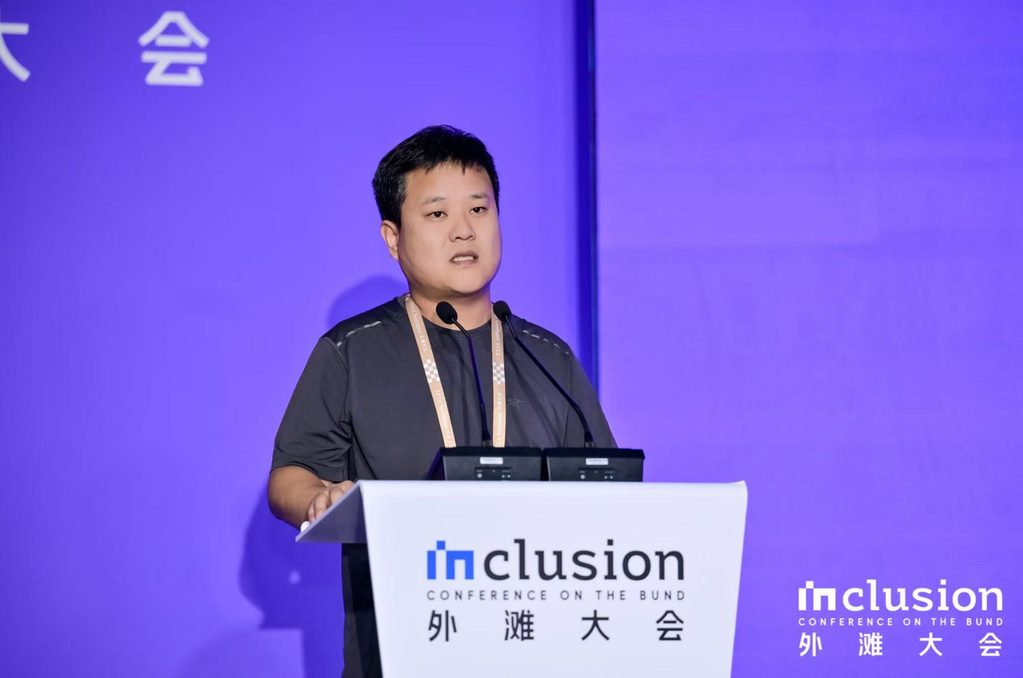
9月11日,外滩大会W2综合采访间,蚂蚁灵波科技CEO朱兴(花名“陶斋”)出现在媒体面前。开场他很直接:自己真名朱兴,在阿里很多年,目前负责蚂蚁灵波,“回答更多代表灵波科技一家之言”。
在这场持续一个半小时的沟通会中,朱兴谈到了Ego数据、世界模型、商业化落地,也谈到了独立融资、人才竞争和“百模大战”。GPLP犀牛财经注意到,他谈得最多的是数据、成本、治理和周期。
在具身智能被资本推上风口的当下,这种克制显得另类。更关键的是,他没有像一些友商那样给出激进的商业化时间表,也没有承诺所谓的“具身智能的ChatGPT时刻”。相反,他把话题拉回到两个更务实的词上:能力与成本。
独立融资不是缺钱 是人才与治理的“长坡厚雪”
今年灵波开始独立融资。外界有消息称,原因之一是集团算力预算受到挤压。对此,朱兴没有刻意回避,但给出了不同的叙事。
“不是说缺钱了。”他说,现有核心人才和未来增量高级人才,需要用什么样的激励机制去容纳,这是必须面对的问题,也是过去一段时间很多大厂拆分AI相关业务背后的重要考量。
独立融资的第二个原因,是公司治理。在朱兴看来,这个行业要“长坡厚雪”,要经历非常多周期。灵波希望提升自身作为独立公司的治理水平,更好地遵循董事会、CEO负责制,让公司更高效地应对竞争。
事实上,灵波的独立拆分,也是一个典型的“大厂AI业务拆分”样本。融资不只是找钱,更是找机制。对于具身智能这种周期长、投入大、人才密度高的赛道,治理结构和激励结构,往往比短期资金更重要。
谈到外界关注的人才问题,朱兴回应说,灵波对外露面不多,但团队最骨干的一批人比较融合:“有学院派往工业界走的,探索新技术范式和上限;有来自自动驾驶等领域的,玩过大规模系统化工程;有数据Infra的人;也有‘互联网+商业’的人。”
数据的真相:百万小时不如一张“配方”
治理之外,数据同样是这场沟通会的高频词。
当有媒体提到“现在数采拿到的数据90%都是无效数据”时,朱兴说,他不知道这个数字是谁说的,怎么统计出来的,但灵波更重视数据本身的质量分布。
“当前确实有一个点,不管哪种类型的数据源、采集方式,数据都有大量场景重复。场景过度重复的数据,意义不是那么大。”
朱兴拿自动驾驶类比:大部分玩自动驾驶的人,每天收上来的数据更多是存储成本,很少能挖掘到真正需要的数据。数据过剩之后,怎么拿到想要的数据,反而非常关键。
灵波的做法是:数据需求由模型训练来定义。需要什么类型的数据、什么分布、涵盖什么场景和任务,采集难度高的先试采,产生好的SOP,再推给供应商上量。
“你会发现整个链路下来,灵波核心走的是定制化采集。我们去年比较早的时间就不怎么买成品数据了。成品数据确实有问题,技术质量差、大量重复,会导致漏斗率很低。”
朱兴透露,灵波比较早地把从原始数据到进入模型训练的数据漏斗,可用率从15%左右拉到90%以上。跟供应商合作,一般不是批量交付,而是流式交付。他们关注从数据生产开始,到底多长时间能进入模型训练,是一周还是三天。
对于行业中一些厂商主张的“自建数采厂”,朱兴认为没必要“非黑即白”。好的数据供应商至少有两个价值:一是专业的大规模用工能力,能管理、考核、激励生产员,产能有弹性;二是未来进入更多场景,本身也需要运营。
“作为模型厂商,你是有义务作为数据需求方的,你得定义出来我需要什么样的数据,需要什么样的质量,不能把这件事赖到数采厂里。这是很核心的Know-how,本身就是模型厂商的责任。”
谈到Scaling Law,朱兴说自己相信,但数据不能机械地看量。
“有的模型多少万小时,比另外一个模型需求量大3倍、5倍,效果差,但会发现它在某些类型场景任务上表现特别好,肯定是数据分布大量不均衡。”
基于此,他分享了几个灵波对数据的判断:
第一,量重要,但不能只谈量,更要谈质量和分布。分布是模型厂商最核心的Knowhow,大家老说“炼丹”,炼丹背后就是配方。
第二,每种数据阶段性都有价值。
第三,不要轻易谈不同数据源之间的配比。互联网视频操作数据配一点点真机数据,会“淹死”。越预训练,越需要场景泛化、无本体数据、互联网视频数据;越往后训练,越贴近机器人、贴近具体场景和任务。
“百模大战”刚开始,生态比通吃更现实
灵波在坚持什么路线?朱兴说,最相信的是物理智能或者具身智能需要基于物理真实数据,去训练自己0-1的基模。
“我们不相信物理智能体或者人形机器人、具身智能仅仅是数字智能的一个嫁接。数字智能的发展,包括多模态、大语言模型,可能会对具身有很多助力,但内核部分还要靠具身本身去解决。”
他提到大语言模型的发展阶段,有两个洞察。
第一,选择问题。大模型兴起后,摆在大厂和新公司面前有两个选择:基于别的基模做微调,或者冒着更大风险投入预训练。后来在“主桌”上的,选择前者的没有一个跑出来,选择后者也不见得跑得出来,但没选择后者的全挂了。
“今天具身智能也进入到‘百模大战’的初期。你选一个更高上限的路线还不见得做得出来,但不选择的话,肯定做不大。”
第二,大语言模型的基础范式相对熟练,为什么就那么几家老在桌上?背后依赖强大的、基于优秀团队交付的Infra能力:大规模训练技术和大规模数据管线。
朱兴认为,至少在具身智能领域,灵波在训练技术方面有竞争力:训练规模超大,很多方向是首发领域的基模,都是原生的。这也是海外非常关注灵波的原因之一。数据维度,灵波很早过渡到定制化采集为主,跟供应商在SOP、端到端数据管线自动化集成等方面做了很多工作。
“我们宣传相对低调,但海外看国内具身智能,尤其是看模型能力,可能不知道‘蚂蚁灵波’四个字,但一定知道‘LingBot’。”
谈到行业格局,朱兴说,从基座公司或基模角度,确实不需要太多家。大模型从轰轰烈烈的“百模大战”到现在比较收敛,四五家坐上“大人那桌”,国内再想上桌也挺难。具身也会走向几家为主,未来一定收敛。但具身今天可能是“百模大战”的刚刚开始。
灵波的核心是输出智能,输出闭源版基模加上工具链。工具链帮助厂商解决更高效的后训练、后训练数据采集、清洗标注、端侧高性能量化部署,以及高效率真机强化学习。过程中提供技术服务,一起探索后训练,培养生态,构建数据网络,尤其让异常数据更多回流。
“对我来说,这种合作是‘1+1大于2’。机器人总体来说是一个非标产品,跟客户需求对接、到集成交付、包括维护,这是非常重的东西。灵波自己做能做几家呢?为什么不是让生态一起来做?”
灵波也有R系列机器人。朱兴解释,一是承载研发需要;二是蚂蚁核心业务围绕生活服务,具身智能想更早探索生活服务,所以需要一个合适的本体。R系列底盘很小,配了非常多感知设备,在力控等方面做了很多软硬件处理。生活服务场景通行、避障更复杂,考虑安全,这不是当前产业主流出货场景,但灵波想更早探索,就需要硬件平台配合。
“工业、物流等出货场景,我们不碰,我们只是提供好‘基模+工具链’。”
商业化:克制 但不缺席
在上述采访的最后,问题回到商业化和周期上。有媒体向朱兴提问称,行业里很多公司融资节奏快,但没有阶段性交付,似乎对资本交代不过去。
朱兴说,大环境和行业发展有规律,肯定有高有低,自动驾驶也穿越了很多周期。在每个周期转化过程中,可能有大量公司告别,有些新公司进来,这很正常。
“具身往前走还是行稳致远的事,行业要更加理性、更加扎实一点往前走,也是一个好事。成本方面我不做披露,反正从0到1大规模训基模挺费钱的。”
对于灵波一年内的计划,朱兴没有给出具体数字。他说,灵波不会为了更好的收入数字去过度推进商业化,一是不可持续,二是会阶段性地把团队精力浪费,捡了芝麻丢了西瓜。灵波选择的是很长期的路线,想上限足够高,过程中会保持克制。
“但再克制不能不做。只有付费的商业化,才能迎接更真实的考验。商业化是公司往前走非常重要的核心能力,再好的技术都是通过不断迎接商业化的挑战沉淀下来的。”
他判断,在未来可见的一两年,在任务复杂度没有那么高的情况下,有些地方的账能逐渐算过来。从今年下半年开始到明后年,应该会进入生产力应用的一个量级的快速增长。
结语
在外滩大会的采访间里,朱兴说了很多“不”:不买成品数据、不追求炫技Demo、不认为数字世界模型能直接控机器人、不认为行业需要这么多基座公司、不为了收入过度推进商业化……
这些“不”构成了蚂蚁灵波的路线:基于物理真实数据,训练0-1的具身基模;用闭源基模+工具链,和生态一起做落地;在有限商业化中打磨能力,等待数据飞轮真正转起来。
具身智能的叙事,过去两年被本体、Demo和融资额推着走。朱兴试图把它拉回地面:先定义数据,再谈模型;先算成本,再谈规模;先做有限落地,再谈数据飞轮。
这个路线不刺激,但却可能更接近产业真实节奏。毕竟,物理世界不接受特效,只接受合理。